Недавно познакомился с крутейшим порталом Leetcode, на котором собрано немыслимое количество алгоритмических задач, обвязанных тестами, качественной постановкой и даже коммьюнити.
Если буквально: читаем условие, решаем задачу, дебажим локально, анализируем сложность алгоритма, оптимизируем, копируем тело метода обратно в окошко (сигнатура метода даётся в условии) и прогоняем набор тестов.

Портал оценивает среднюю скорость выполнения на разных наборах входных данных и объём задействованной памяти. По итогам тестов указывается, в каком перцентиле находится ваше решение по скорости и памяти:
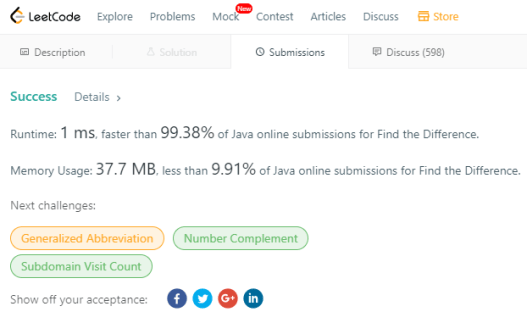
Портал может и не уникален в своём роде, но мне понравился.
Задача о поиске различий
Сегодня мне попалась такая задача:
Даны две строки – s и t, состоящие исключительно из строчных букв. Строка t сгенерирована случайной перестановкой всех символов строки s, при этом в случайную позицию строки t была добавлена еще одна случайная буква. Найдите букву, добавленную к t.
Пример:
Input: s = “abcd” t = “abcde”
Output: e
Explanation: ‘e’ is the letter that was added.
Вот такая реализация получилась у меня:
public static char findTheDifference(String s, String t) {
        long sourceSum = 0;
        long destSum = 0;
        for (char ch : s.toCharArray()) {
            sourceSum += ch;
        }
        for (char ch : t.toCharArray()) {
            destSum += ch;
        }

        return (char) (destSum - sourceSum);
    }
Вспомним, чем является char в Java? Фактически это 16-битный код символа в Unicode (UTF-16), диапазон его значений – от 0 до 65536 (отрицательных не существует).
То есть мы буквально можем найти сумму всех элементов исходной строки (sourceSum), сумму всех элементов дополненной строки (destSum), а модуль их разности даст код того самого добавленного символа, который необходимо найти.
Решение оказалось далеко не в топе по утилизации памяти, а вот скорость попала в топ 0,6%, что меня весьма порадовало.
Насколько я могу судить, получившаяся реализация имеет линейную сложность, O(n) в нотации O-большое.